Mettiti in contatto se hai moduli, bolle d'ordine, report, contratti, moduli di richiesta, cartoline di risposta (campagne) o simili che vuoi convertire rapidamente in un database.
Per l'interpretazione dei moduli utilizziamo la tecnologia di acquisizione dati a modulo fisso (la stessa usata per i sondaggi) oppure la tecnologia flessibile di acquisizione dati, poiché quest'ultima non richiede i contrassegni di registrazione normalmente utilizzati con la tecnologia a modulo fisso, ad es. i sondaggi.
Interpretazione di moduli con tecnologia flessibile di acquisizione dati
L'interpretazione con tecnologia flessibile di acquisizione dati funziona in modo del tutto diverso dall'interpretazione dei moduli fissi, con contrassegni di riferimento e campi in posizioni fisse. Invece di interpretare posizioni fisse, si basa sull'uso dell'OCR per individuare parole ancora predefinite, come "Contract", "contract no.", "Order no.", "Order slip:", "Report no.:" o simili, e poi sull'impostazione di condizioni per individuare una stringa di caratteri adatta in prossimità dell'ancora, o quantomeno in relazione a essa. Si impostano condizioni su come deve apparire la stringa di caratteri cercata, come il numero di caratteri, quali caratteri sono ammessi, e così via. Vedi sotto la parola ancora "REPORT" in blu e il numero di report acquisito in verde.
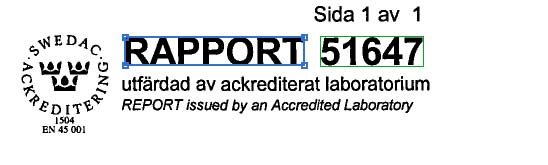
Lo stesso tipo di contratto ha spesso un aspetto identico, ma è sufficiente che uno dei contratti sia una fotocopia, o sia stampato su una stampante diversa, perché non corrisponda più a un modello a modulo fisso, dove le esigenze di precisione millimetrica sono elevate. Un buon esempio di quando ciò accade inevitabilmente è se pubblichi un PDF contenente, ad esempio, un modulo di richiesta per un nuovo aumento di capitale che viene poi scaricato da varie persone e successivamente stampato su stampanti diverse. In tal caso è preferibile invece la tecnologia flessibile di acquisizione dati per moduli semi-strutturati.
Acquisizione dati con IA – alternativa e complemento all'OCR classico
I modelli di IA per l'interpretazione delle immagini degli ultimi anni ci hanno offerto un potente complemento all'OCR classico e all'acquisizione dati basata su modelli. Invece di cercare parole di ancoraggio in posizioni fisse, l'IA legge la pagina più come farebbe una persona – capisce dal contesto che cosa significa un campo, anche quando il modulo ha un aspetto diverso rispetto alla volta precedente. Questo ci permette di trattare materiale che in passato avrebbe richiesto l'inserimento manuale.
Quando la lettura con IA è più utile
- Moduli senza un modello uniforme: quando ogni esemplare ricevuto è leggermente diverso e nessun modello fisso è adatto.
- Originali di difficile lettura: fotocopie, copie di copie, scansioni storte, stampe sbiadite e documenti antichi.
- Dati manoscritti: campi compilati a mano, annotazioni a margine e righe di firma che l'OCR tradizionale non riesce a gestire.
- Campi che richiedono comprensione: distinguere un codice fiscale personale da una partita IVA, individuare la data giusta fra più date, oppure stabilire quale dei due numeri presenti sulla pagina sia il numero di contratto.
L'IA come revisore dei dati acquisiti tramite OCR
L'impiego forse più importante per noi è l'IA come secondo paio di occhi. Dopo che i dati sono stati acquisiti con OCR o con tecniche di data capture, facciamo rileggere all'IA ogni dato incerto direttamente dall'immagine scansionata e lo confrontiamo con quanto è finito nel database. In questo modo intercettiamo proprio gli errori più difficili da rilevare in modo automatico: la cifra 1 letta come la lettera l o I, lo 0 come O, e le parole unite o troncate.
Abbiamo realizzato questo controllo proprio per il tipo di campi brevi che i moduli contengono – numeri, date e importi, ma anche nomi, indirizzi e-mail e testo libero breve. Ogni dato incerto viene verificato sull'immagine originale prima della consegna.
Sempre verificato sull'immagine originale
Un modello di IA può sbagliare, e un'ipotesi che appare plausibile è più pericolosa di un errore OCR evidente. Per questo non usiamo mai la lettura con IA senza controlli. Ogni dato viene validato sia in modo deterministico rispetto a regole che stabiliamo – numero di caratteri, caratteri ammessi, cifra di controllo, ricerca in un registro – sia visivamente rispetto all'immagine scansionata. Ciò che non può essere confermato sull'immagine passa alla revisione manuale.
Inoltre, l'acquisizione dati con IA viene spesso combinata con un ultimo giro in cui esamino personalmente i risultati a confronto con l'immagine, con i miei occhi. La validazione automatica e il controllo dell'IA intercettano la maggior parte dei casi, ma è in quest'ultima verifica che i rari errori anomali tendono a emergere. È anche per questo che mi permetto di promettere una precisione così elevata in incarichi di questo tipo.
Scegliamo la tecnica in base al materiale
Tecnica a modulo fisso, acquisizione flessibile e lettura con IA non si escludono a vicenda – le combiniamo spesso nello stesso incarico e lasciamo che ciascuna tecnica faccia ciò in cui riesce meglio. Inviateci pure alcune pagine di esempio, ad esempio foto scattate con il cellulare, e vi risponderemo con una proposta di impostazione e un prezzo.